
في هذا المقال
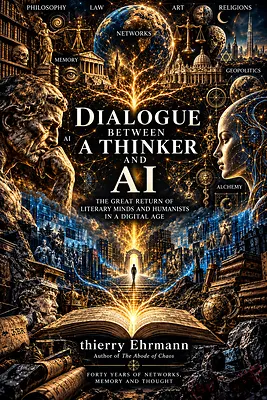
تخوض خمسة نماذج الذكاء الاصطناعي تجربة تحليلية جديدة في باريس تعتمد على قراءة كتاب فكري موحد ومقارنة التقييمات المتبادلة بين الأنظمة المختلفة. وتستند هذه الخطوة إلى كتاب حوار بين المفكر والذكاء الاصطناعي الذي ألفه تيري إيرمان بعد مئات الساعات من النقاشات الفكرية والأرشيفية الموثقة.
يتوفر العمل حالياً في نسخ ورقية مطبوعة باللغتين الإنجليزية والفرنسية، بينما لا تتوقف التجربة عند استيعاب محتوى النص فقط. وتسعى هذه المبادرة إلى اختبار سلوك الأنظمة التقنية عند مطالعة تحليلات بعضها، مما يدعم أبحاث الذكاء الاصطناعي المستمرة في الأوساط المعرفية.
مفهوم القراءة الفوقية لكتاب واحد
تشمل الأنظمة المشاركة كلاً من OpenAI Astra وPerplexity وDeepSeek وGoogle Gemini إضافة إلى منصة xAI Grok. وقدم القائمون على التجربة النص ذاته إلى هذه الأنظمة لمعرفة طبيعة الاستنتاجات والمفاهيم التي يحددها كل نموذج بصورة تلقائية داخل سياق موحد.
ولا تهدف التجربة إلى عقد منافسة تقليدية لتحديد النظام الأفضل بين المنصات المشاركة. وتعمل بدلاً من ذلك على رصد نقاط التوافق والاختلاف، مع مراقبة المسائل غير المكتشفة في قراءات برمجيات التطبيقات والبرمجيات المتقدمة.
مشاركة نماذج الذكاء الاصطناعي في التحليل المتبادل
تنتقل التجربة إلى مرحلة جديدة عندما تطلع مختلف نماذج الذكاء الاصطناعي على المراجعات النقدية التي أنتجتها الأنظمة المنافسة. وبذلك يتحول كل نظام إلى قارئ ومحلل للنقد الأدبي الذي صاغته النماذج الأخرى حول الكتاب الأصلي.
ويتيح هذا الأسلوب دراسة كيفية استجابة منصة Gemini للتحليل النقدي الصادر عن منصة Grok بدقة. وفي السياق ذاته، ترصد التجربة ردود نظام DeepSeek حيال الملاحظات والتقييمات التي سجلها نظام OpenAI Astra في قراءته للكتاب.
تغير اتجاه النقد والمقارنة المعرفية
اعتمد النقد الأدبي لقرون طويلة على القراء البشريين لتفسير محتوى الكتب وتقييم معانيها. وتقدم التجربة الحالية منظوراً مغايراً يعتمد على توظيف النص لفهم آليات عمل الأنظمة التي تقرأه وتفسر محتواه في قطاع التعليم والتدريب والبحث المعرفي.
وتتحول قراءات الأنظمة إلى مرآة معرفية ترصد أسباب تباين التفسيرات الناتجة عن المدخلات الموحدة. ويوفر هذا التباين بيانات تحليلية مستقلة تكشف كيفية معالجة النصوص وربط الأفكار عبر مختلف نماذج الحوسبة.
دور العنصر البشري في التقييم النهائي
تؤكد التجربة بقاء التقييم النهائي والسياق الفكري في يد العنصر البشري بصفته المرجع الأساسي للحكم والمقارنة. وتنتج الآلات قراءات متعددة، في حين يتولى الباحث البشري التدقيق والمقارنة بين الفجوات التحليلية ورسم الاستنتاجات الشاملة.
ويظل كتاب تيري إيرمان منصة لتجربة مستمرة حول تعددية منطلقات نماذج الذكاء الاصطناعي. ومن ثم يتيح هذا العمل للباحثين فرصة متابعة التفاعل النقدي بين الأنظمة الآلية وتطوره المستقبلي بدقة ووضوح.
تخوض خمسة نماذج الذكاء الاصطناعي تجربة تحليلية جديدة في باريس تعتمد على قراءة كتاب فكري موحد ومقارنة التقييمات المتبادلة بين الأنظمة المختلفة. وتستند هذه الخطوة إلى كتاب حوار بين المفكر والذكاء الاصطناعي الذي ألفه تيري إيرمان بعد مئات الساعات من النقاشات الفكرية والأرشيفية الموثقة.
يتوفر العمل حالياً في نسخ ورقية مطبوعة باللغتين الإنجليزية والفرنسية، بينما لا تتوقف التجربة عند استيعاب محتوى النص فقط. وتسعى هذه المبادرة إلى اختبار سلوك الأنظمة التقنية عند مطالعة تحليلات بعضها، مما يدعم أبحاث الذكاء الاصطناعي المستمرة في الأوساط المعرفية.
مفهوم القراءة الفوقية لكتاب واحد
تشمل الأنظمة المشاركة كلاً من OpenAI Astra وPerplexity وDeepSeek وGoogle Gemini إضافة إلى منصة xAI Grok. وقدم القائمون على التجربة النص ذاته إلى هذه الأنظمة لمعرفة طبيعة الاستنتاجات والمفاهيم التي يحددها كل نموذج بصورة تلقائية داخل سياق موحد.
ولا تهدف التجربة إلى عقد منافسة تقليدية لتحديد النظام الأفضل بين المنصات المشاركة. وتعمل بدلاً من ذلك على رصد نقاط التوافق والاختلاف، مع مراقبة المسائل غير المكتشفة في قراءات برمجيات التطبيقات والبرمجيات المتقدمة.
مشاركة نماذج الذكاء الاصطناعي في التحليل المتبادل
تنتقل التجربة إلى مرحلة جديدة عندما تطلع مختلف نماذج الذكاء الاصطناعي على المراجعات النقدية التي أنتجتها الأنظمة المنافسة. وبذلك يتحول كل نظام إلى قارئ ومحلل للنقد الأدبي الذي صاغته النماذج الأخرى حول الكتاب الأصلي.
ويتيح هذا الأسلوب دراسة كيفية استجابة منصة Gemini للتحليل النقدي الصادر عن منصة Grok بدقة. وفي السياق ذاته، ترصد التجربة ردود نظام DeepSeek حيال الملاحظات والتقييمات التي سجلها نظام OpenAI Astra في قراءته للكتاب.
تغير اتجاه النقد والمقارنة المعرفية
اعتمد النقد الأدبي لقرون طويلة على القراء البشريين لتفسير محتوى الكتب وتقييم معانيها. وتقدم التجربة الحالية منظوراً مغايراً يعتمد على توظيف النص لفهم آليات عمل الأنظمة التي تقرأه وتفسر محتواه في قطاع التعليم والتدريب والبحث المعرفي.
وتتحول قراءات الأنظمة إلى مرآة معرفية ترصد أسباب تباين التفسيرات الناتجة عن المدخلات الموحدة. ويوفر هذا التباين بيانات تحليلية مستقلة تكشف كيفية معالجة النصوص وربط الأفكار عبر مختلف نماذج الحوسبة.
دور العنصر البشري في التقييم النهائي
تؤكد التجربة بقاء التقييم النهائي والسياق الفكري في يد العنصر البشري بصفته المرجع الأساسي للحكم والمقارنة. وتنتج الآلات قراءات متعددة، في حين يتولى الباحث البشري التدقيق والمقارنة بين الفجوات التحليلية ورسم الاستنتاجات الشاملة.
ويظل كتاب تيري إيرمان منصة لتجربة مستمرة حول تعددية منطلقات نماذج الذكاء الاصطناعي. ومن ثم يتيح هذا العمل للباحثين فرصة متابعة التفاعل النقدي بين الأنظمة الآلية وتطوره المستقبلي بدقة ووضوح.
